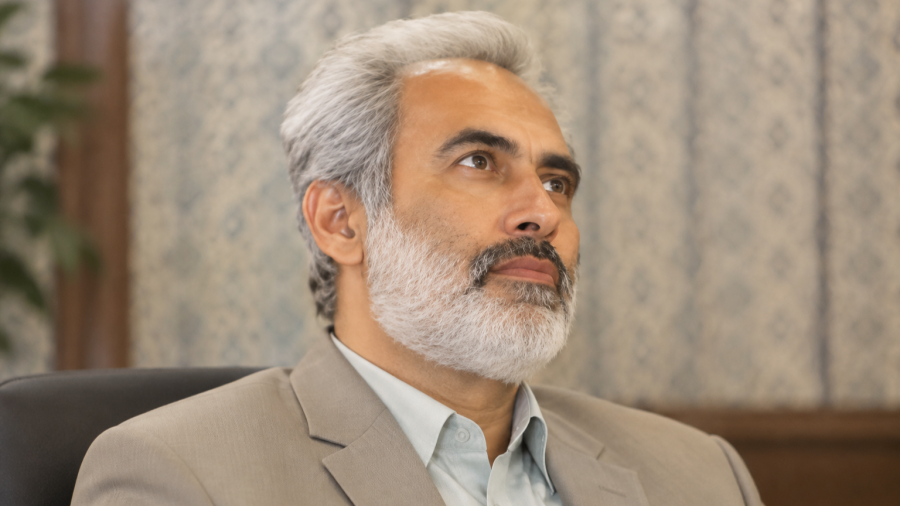
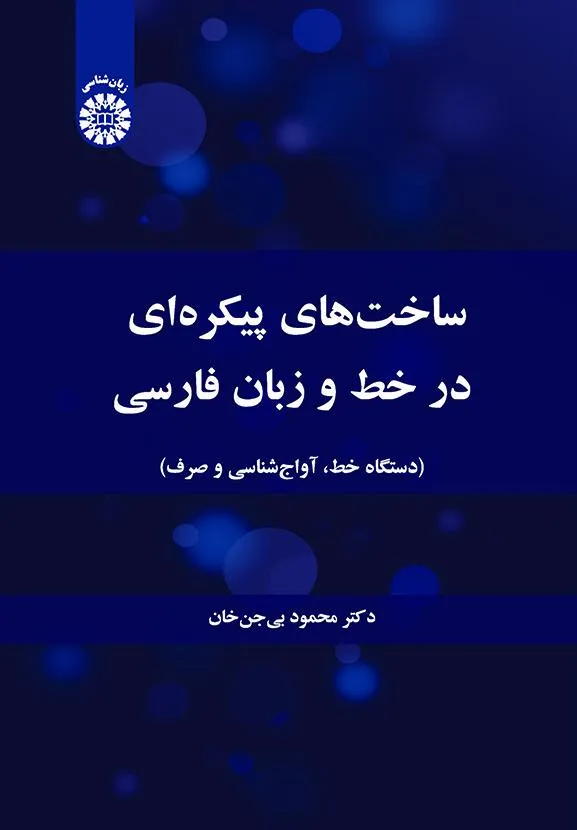
محمود بیجنخان، استاد زبانشناسی، در گفتوگو با «سمت»، از کتاب تازه منتشرشدهاش با عنوان «ساختهای پیکرهای در خط و زبان فارسی» میگوید. اثری که حاصل سالها پژوهش و شش سال تلاش است و در آن بهجای نگاه دوارزشی «خوشساخت/بدساخت»، الگوهای زبانی پربسامد در سطوح واجشناسی، صرف، نحو، معناشناسی و گفتمانشناسی با اتکا به پیکرههای گفتاری و نوشتاری استخراج شدهاند. به گفته او، این کتاب با دو رویکرد «پیکرهبنیاد» و «پیکرهمحور» تدوین شده و مخاطبان اصلی آن دانشجویان زبانشناسی، آموزش زبان فارسی به غیرفارسیزبانان، زبانشناسی رایانشی، مهندسی مخابرات، گفتاردرمانی و شنواییشناسی هستند.
موضوع کتاب شما با عنوان «ساختهای پیکره ای در خط و زبان فارسی»، که به تازگی از سوی انتشارات «سمت» منتشر شده، چیست؟
موضوع این کتاب، مطالعه خط و زبان فارسی است. ما در زبان فارسی ساختارها یا الگوهای زبانی داریم که در سطوح واجشناسی، صرف، نحو، معناشناسی و گفتمانشناسی قرار دارند. این الگوها باید با استفاده از پیکرههای زبانی استخراج شوند. نکته مهم این کتاب این است که این الگوها یا همان ساختارها، بر حسب «بسامد» یا «فراوانی» از پیکرههای زبانی استخراج میشوند؛ این پیکرهها میتوانند پیکرههای گفتاری باشند یا پیکرههای نوشتاری. کل ماجرای این کتاب همین است. در واقع در این کتاب، به جای اینکه ما به دنبال الگوهای «خوشساخت» و «بدساخت» به صورت دوارزشی باشیم، میرویم سراغ اینکه چه الگوهایی پربسامد هستند و در سطوح مختلف زبان، چه الگوهایی فراوانی بیشتری دارند. ما این مطالعه را در دو حوزه انجام میدهیم: یکی با رویکرد «پیکرهبنیاد» و دیگری با رویکرد «پیکرهمحور». در رویکرد پیکرهبنیاد، ما یافتههای نظری را که بر اساس دادههای پیکره نبودهاند بلکه بر اساس شمّ زبانیِ تحلیلگر به دست آمدهاند، بررسی میکنیم. اما در رویکرد پیکرهمحور، ما کاری به الگوهای نظریِ از پیش به دست آمده نداریم، بلکه از پیکره استفاده میکنیم تا خودمان به نظریهپردازی برسیم؛ البته این نظریهپردازی هم بر اساس همان الگوهای پربسامد است.
آقای دکتر؛ چه چیزی باعث شد احساس کنید نوشتن چنین اثری در این مقطع زمانی برای زبان فارسی ضروری است؟
ببینید ما دو نوع ضرورت داریم. ضرورت اول مربوط به خودِ رشته زبانشناسی و مطالعه خط و زبان فارسی است. زبانشناسان (و حتی ادیبان) خود را با خط درگیر میکنند؛ چرا که متون ادبی برای تحقیقاتشان بسیار مهم هستند و شواهد ادیبان برای خط و زبان فارسی عمده است. اما زبانشناسان بیشتر از گفتارِ اهل زبان برای الگوهای زبانشان استناد میکنند، نه فقط مکتوبات؛ بلکه گفتههای اهل زبان یا نویسندگان و زبانبران. ما در این کتاب هم به «خط» توجه داشتیم و هم به خودِ «زبان»؛ یعنی هم به زبان نوشتاری و هم به زبان گفتاری توجه داشتیم. وقتی الگوهای پربسامد را استخراج کردیم، به هر دو گونهی کلان زبانی (نوشتار یا گفتار) توجه داشتیم. ابزار ما پیکرههای زبانی بودند که خودشان یا نوشتاری هستند یا گفتاری؛ پس ما هر دو منبع را داشتیم. بنابراین ضرورت اول، مطالعه همزمان خط و زبان فارسی است. این کار که ما اسمش را گذاشتهایم «دادهشناسی»، یعنی شناخت دادههای نوشتاری و گفتاری فارسی با توجه به فراوانی وقوع آنها؛ این کارِ اصلی زبانشناسهاست. ضرورت دوم مربوط به «پردازش زبان» (نوشتاری و گفتاری) است؛ منظورم هم پردازش ذهنی است که مربوط به حوزه روانشناسی زبان است و هم پردازش رایانشی که امروزه بسیار رواج یافته و در اولویتهای کلان دولتها قرار گرفته است.
نوشتن این کتاب چقدر طول کشید؟
حدود شش سال.
این کتاب جلد دومی هم دارد؟
بله، اما نظر من این است که چون مثلاً یک جلد حدود ۲۵۰ تا ۶۰۰ صفحه است و این کتاب ۵۵۰ صفحه دارد، اگر در مجموع بشود ۸۰۰ صفحه، بهتر است در یک جلد باشد. اگر امکانش باشد ترجیح میدهم در یک جلد باشد.
آقای دکتر، آیا موضوعاتی که در این کتاب به آنها اشاره شده، در کتابهای قبلی هم منتشر شده بود؟
کتاب از نظر من «تجدید» (تکرار) نیست، بلکه از نظر «تحلیل» بالاتر است؛ چرا که من تمام محتوای آن را با استفاده از برنامهنویسی روی پیکره به دست آوردهام. بنابراین مطالب جدید هستند، هرچند در جاهایی به کارهای قبلی ارجاع دادهام (مثل همه کتابها).
موقع نوشتن این کتاب، با چالشهای غیرمنتظرهای روبهرو شدید که برای شما (به دلیل ماهیت زبان فارسی) ناآشنا باشد؟ یعنی این تحقیق و پژوهش برای تألیف این کتاب، شما را وارد چالش جدیدی کرده باشد؟
بله وجود داشته. علت آن هم این است که زبانشناسی فارسی بیشتر مبتنی بر این است که تحلیلگر به «دانش زبانی خود» استناد کند. مثلاً وقتی من با «شناخت» کار میکنم، برای تلفظ کلمات به این مراجعه میکنم که خودم چطور آن را تلفظ میکنم؛ کمتر پیش میآید که به سراغ پیکرهای با حجم اطلاعات ۳۰۰ یا ۴۰۰ نفر بروم. بنابراین وقتی مسئلهای را در حوزه زبانشناسی نظری، با استناد به دانش زبانی خودتان (یا حداکثر چند نفر) انجام میدهید، با زمانی که استناد به یک پیکره با حجم بسیار زیاد از متون انجام میدهید، بسیار متفاوت است. در این حالت کار تحلیلی سختتر میشود و شما مجبورید یافتهها را دقیقاً همانگونه که هستند گزارش کنید و اگر با یافتههای مبتنی بر دانشِ افراد محدود تفاوت داشت، آن تفاوتها را توضیح دهید. پس بله، چالشهای زیادی از این دست وجود داشت.
مخاطبان این کتاب چه کسانی هستند؟
دانشجویان رشته زبانشناسی؛ البته هر رشتهای از زبانشناسی. کتابی که الان تألیف کردهام در حوزه آواشناسی است (ترکیب آواشناسی و شناخت)، اما بعداً میخواهم معنیشناسی و گفتمانشناسی را هم اضافه کنم. پس دانشجویان زبانشناسی میتوانند از آن استفاده کنند. همچنین دانشجویان «آموزش زبان فارسی به غیرفارسیزبانان» بسیار میتوانند از آن بهره ببرند. حوزههای زبانشناسی رایانشی (دانشجویان مهندسی که در پردازش زبان طبیعی یا مهندسی نرمافزار کار میکنند)، مهندسی مخابرات (که با پردازش متن سر و کار دارند)، گفتاردرمانی و شنواییشناسی (در بخش آواشناسی) از مخاطبان این کتاب هستند.
سختترین بخش نوشتن این کتاب برای شما کدام فصل بود؟
همه آنها به یک اندازه سخت بودند، اما اگر بخواهم بگویم، فصل اول که مربوط به تاریخچه بود، سختترین بود. اگرچه بخش فنی نبود و بیشتر جنبه توصیفی-تحلیلی داشت، اما چون باید از دوران هند باستان تا قرن بیست و یکم را بررسی میکردم تا ببینم در کارهای دستورنویسان سنتی از پیکره استفاده شده یا خیر، بسیار دشوار بود. فصلهای بعدی هم سختی خودشان را داشتند، اما سختیشان از این جهت بود که وقت زیادی از من گرفت؛ چون باید به دانشجویانم که در برنامهنویسی مهارت داشتند میسپردم تا کدها را بنویسند، من نتیجه را میگرفتم و سپس شروع به تفسیر و تحلیل میکردم. خلاصه هر کدام سختی خودشان را داشتند، اما اگر بخواهید بدانید، فصل اول برای من سختترین بود.
اطلاعات بیشتر درباره این کتاب را میتوانید با زدن روی این متن مشاهده کنید
افزودن دیدگاه جدید